Array in Javascript: l'essenziale e qualcosa in più
Un array è un oggetto globale che può contenere diversi elementi al suo interno. Funziona anche come un elenco, uno stack o una coda (queue in inglese) in Javascript. All’interno possiamo trovare elementi dello stesso tipo o invece una combinazione di tipi non omogenei tra di loro.
Definiamo un array:
const arrayNazioni = [‘India’, ‘Germania’, ‘China’, ‘Giappone’];
Possiamo anche definire un array usando il costruttore:
const array = new Array(‘India’, ‘Germania’, ‘China’, ‘Giappone’);
I metodi essenziali
Esistono molti metodi negli array in Javascript. Vedremo i più importanti in questo articolo, osservando la sintassi e facendo un esempio per rendere l’utilizzo più chiaro.
•Map
La funzione “Map” è uno dei metodi disponibili sul tipo di un array in JS. Crea un nuovo array con i risultati delle chiamate di una funzione callback su ogni elemento dell’array chiamante.
La sintassi è:
array.map((valore, indice, array) => {…….});
Il ‘valore’ è il valore dell’elemento corrente, ‘indice’ è l’indice dell’array dell’elemento corrente e l’array è l’oggetto dell’array a cui appartiene l’elemento corrente.
Facciamo un esempio:
const array = [5,10,15,20];
//passiamo la funzione a map
const newArray = array.map(x=>x*10);
console.log(newArray); //[50,100,150,200]
Possiamo anche creare un nuovo array che contiene una proprietà singola dell’array, per esempio:
const prodotti = [
    {nome: ’Mobile’, prezzo: [800,1000]}
    {nome: ’Playstation’, prezzo: [300,400]}
    {nome: ‘Xbox’, prezzo: [350,425]}
]

const tuttiPrezzi = prodotti.map(prodotti => prodotti.prezzi);
console.log(tuttiPrezzi); //[[800,1000],[300,400], [350,425]]
Esiste un altro modo per iterare sugli oggetti di un array, ossia il metodo forEach().
array.forEach((number, i) => {
    newArray[i] = number *5;
});
console.log(newArray); //[5,10,20,25]
La differenza principale tra map() e forEach() è che map restituisce il valore tramite la funzione di callback. Nel caso di forEach, invce, non succede nulla col valore tornato dalla stessa funzione. Quindi è bene scegliere il metodo più adatto alle proprie esigenze.
•Reduce
Il metodo Reduce() esegue una funzione di ‘riduzione’
che forniamo su ciascun elemento dell’array, che si traduce quindi in un
singolo valore di output. La sintassi è la seguente:
arr.reduce(callback(accumulatore, valoreCorrente, indice, array), valoreIniziale)
La
funzione di callback (reducer) accetta due argomenti separati:
l’accumulatore, ossia il valore momentaneo corrente, e il valoreCorrente ossia
l’elemento analizzato in quel dato momento nel ciclo. Il valore restituito
viene utilizzato come accumulatore per l’elemento successivo nel ciclo.
Nel primo ciclo viene invece utilizzato il valoreIniziale fornito (facoltativo).
L’indice è ovviamente l’indice dell’array dell’elemento corrente, l’array
invece è l’oggetto dell’array a cui appartiene l’elemento che si vuole
analizzare Il valoreIniziale, indice e array sono tutti facoltativi, quindi a
seconda del contesto è bene utilizzarli o meno.
const array2 = [10,20,30,40];
const reducer = (accumulatore, valoreCorrente) => accumulatore + valoreCorrente;
console.log(array2.reduce(reducer)); //100
Proviamo ad usare la stessa logica con forEach() per capire la differenza:
let totale = 0;
array2.forEach(function(num) {
totale = totale + num;
});
console.log(total); //100
•Filter
A differenza di map(), il metodo filter()
crea un nuovo array con tutti gli elementi che superano la condizione
implementata dalla funzione di callback, un vero e proprio “filtro”. La
sintassi è la seguente:
array.filter(callback, [thisObject]);
Esempio:
var numeri = [12,7,18,9,11,2,35];
const risultati = numeri.filter(numeri => numeri > 10);
console.log(risultati); //[12,18,11,35]
•Sort
Sort() viene utilizzato per ordinare gli elementi di un array. L’oggetto
fornito alla funzione muta, quindi stiamo modificando l’array originale.
La complessità temporale e spaziale dell’ordinamento non è costante nel tempo
in quanto dipende da come viene implementato il metodo.
Ecco un esempio:
let arraySort = [‘India’, ‘Germania’, ‘China’, ‘Giappone’];
console.log(‘sorted array: ‘, arraySort.sort()); // [‘China’, ’Germania’, ‘India’, ‘Giappone’]
//ordinati in ordine alfabetico
•Reverse
Reverse() è usato negli array per invertire l’ordine degli elementi. Anche in questo caso siamo di fronte ad un metodo che muta l’array.
Ecco un esempio:
let arraySort = [‘India’, ‘Germania’, ‘China’, ‘Giappone’];
console.log(‘reversed array: ‘, array.Sort.reverse()); // [‘Giappone’, ’China’, ’Germania’, ’India’]
Conclusioni
In questo breve articolo abbiamo trattato alcuni
importanti metodi degli array in Javascript, la loro sintassi e il loro
utilizzo. Gli array vanno utilizzati con cura perché sono strutture dati molto
performanti ma se utilizzate nella maniera errata possono portare ad enormi bug
nelle applicazioni. La scelta dei giusti metodi e di come implementarli è solo
il primo passo per trattare con un argomento così importante! Buona
programmazione a tutti!
FONTE: https://medium.com/swlh/the-essentials-of-javascript-arrays-68f39339038e

VUE.js: la componente di testing e cosa testare
Una delle domande più frequenti che gli sviluppati del framework Vue.js si pongono è: “Ma esattamente, cosa dovrei testare?”. Nello sviluppo di un'applicazione in produzione, questa è forse la domanda più frequente e che ad oggi non ha ancora ricevuto una risposta definitiva. Mentre è possibile testare troppo o troppo poco, la nostra osservazione è che gli sviluppatori molto spesso sbagliano a testare qualsiasi componente della loro applicazione, perdendo tempo e risorse utili da impiegare in altri ambiti. In questo articolo vogliamo condividere con voi alcune linee guida che utilizziamo nei nostri test dei componenti, per fornire una copertura sufficiente ad evitare grossi bug e per non perdere troppo tempo nello scrivere test ripetitivi e molto spesso inutili. Sapere cosa testare è quasi più importante che essere un esperto nello scrivere i test stessi. Diamo ovviamente per scontato che il lettore abbia già una buona infarinatura su Jest e sul Vue Test Units, utilizzando questo ambiente di sviluppo di Vue.js.
Esempio componente
Prima di arrivare alle linee guida cerchiamo di familiarizzare con il seguente componente che testeremo. Si chiama dress.vue ed è un articolo all’interno di un app di un e-commerce.
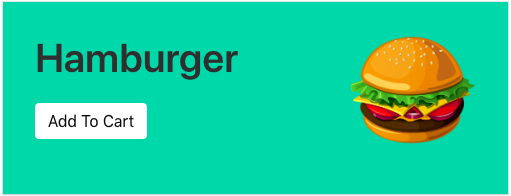
Qui ci sono i componenti del codice. Come vedete ci sono tre dipendenze: Vuex ($store), Vue Router ($router) e Vue Auth ($auth).
dress.vue
<template>
   <div>
     <h2>{{ item.title }}</h2>
     <button @click="addToCart">Add To Cart</button>
     <img :src="item.image"/>
    </div>
  </template>
  <script>
  export default {
    name: "Item",
    props: [ "id" ],
    computed: {
      item () {
        return this.$store.state.find(
          item => item.id === this.id
        );
       }
      },
      methods: {
        addToCart () {
          if (this.$auth.check()) {
            this.$store.commit("ADD_TO_CART", this.id);
          } else {
            this.$router.push({ name: "login" });
          }
        }
     }
  };
  </script>
Specifiche per il setup del file
Qui invece troviamo le specifiche per il test. All’interno mostreremo
superficialmente i nostri componenti con Vue Test Utils, lo abbiamo importato
come component “dress” che stiamo testando. Abbiamo anche creato una funzione
che genererà un oggetto di configurazione irreversibile, risparmiando le
specifiche per i props e aggirando le tre dipendenze.
item.spec.js
import { shallowMount } from "@vue/test-utils";
import Item from "@/components/Item";
function createConfig (overrides) {
  const id = 1;
  const mocks = {
    // Vue Auth
    $auth: {
      check: () => false
  },
  // Vue Router
  $router: {
    push: () => {}
  },
  // Vuex
  $store: {
   state: [ { id } ],
   commit: () => {}
  }
 };
 const propsData = { id };
 return Object.assign({ mocks, propsData }, overrides);
}
describe("Item.vue", () => {
// Tests go here
});
Identifichiamo la logica di base
Quando ci si approccia ai test, la prima e più importante domanda da porsi di fronte ad un componente è: “Qual è la logica di base? Cosa deve fare il componente?”
Per Item.vue ecco la logica:
• Verrà visualizzato un articolo in base alla proprietà id ricevuto,
• Se l’utente è un ospite del sito, facendo click sul pulsante “Aggiungi al carrello” lo reindirizza alla pagina di accesso,
• Se l’utente ha già effettuato l’accesso, facendo click su “Add To Cart” si attiverà una mutazione Vuex ADD_TO_CART.
Input e Output
Il trucco quando testate un'unità di un componente è trattare tale componente come una scatola nera. La logica interna dei metodi, delle proprietà computazionali ecc, conta solo nella misura in cui influiscono sugli output.
La prossima cosa molto importante da fare è identificare input e output del componente, poiché queste saranno anche gli stessi del test.
Nel caso di Item.vue gli input sono:
•Stato da Vuex e VueAuth,
•Input dell’utente trammite click sul pulsante.
Gli output invece sono:
•Markup renderizzato,
•Dati inviati alla mutazione Vuex o il push Vue Router.
TEST 1: router chiamato quando l’ospite clicca sul pulsante
Una parte della logica descritta prima ci dice “Se l’utente è un ospite, facendo click sul pulsante “Add to cart”, viene reindirizzato alla pagina di accesso”. Proviamo a scriverlo come test.
Configureremo il test facendo un allestimento superficiale del componente, cliccando sul pulsante “Add to cart”.
test("router called when guest clicks button", () => {
 const config = createConfig();
 const wrapper = shallowMount(Item, config);
 wrapper
.find("button")
.trigger("click");
// Assertion goes here
}
Non andare oltre i limiti di input e output
In questo primo test potresti essere tentato di verificare che il percorso sia
cambiato rispetto alla pagina di accesso dopo aver fatto click sul pulsante, ad
esempio.
import router from "router";
test("router called when guest clicks button", () => {
 ...
 // Wrong
 const route = router.find(route => route.name === "login");
 expect(wrapper.vm.$route.path).toBe(route.path);
}
Mentre
questo test verifica implicitamente l’output del componente, fa anche
affidamento sul funzionamento del router, che non dovrebbe essere la nostra
preoccupazione principale.
E’ meglio testare direttamente l’output, ossia la chiamata router.push.
Il completamento dell’operazione da parte del router non rientra però
nell’ambito specifico di questo test.
Spiamo (con spy) il metodo push del router e possiamo dire che viene
chiamato come oggetto route di accesso.
import router from "router";
test("router called when guest clicks button", () => {
 ...
 jest.spyOn(config.mocks.$router, "push");
 const route = router.find(route => route.name === "login");
 expect(spy).toHaveBeenCalledWith(route);
}
TEST 2: Vuex chiamato quando utente Auth clicca il pulsante
Dopo aver completato il primo test ci approciamo alla logica del “Se l’utente ha effettuato l’accesso, facendo click sul pulsante “Add to cart” si attiverà una mutazione Vuex “ADD_TO_CART”.
Come nel caso precedente non è necessario verificare se lo stato di Vuex viene modificato: avremo, infatti, un test separato per l’archivio Vuex per verificarlo. Il compito di questo componente è semplicemente quello di effettuare il commit. Quindi, per prima cosa sostituiamo $auth.check in modo che ritorni true (come se un utente avesse effettuato l’accesso). Poi useremo il metodo spy di nuovo sul commit di store, e affermeremo che è stato chiamato dopo aver fatto click sul pulsante.
test("vuex called when auth user clicks button", () => {
  const config = createConfig({
  mocks: {
    $auth: {
      check: () => true
    }
   }
  });
  const spy = jest.spyOn(config.mocks.$store, "commit");
  const wrapper = shallowMount(Item, config);
  wrapper
   .find("button")
   .trigger("click");
  expect(spy).toHaveBeenCalled();
}
Non testate le funzionalità delle altre librerie
Il componente Item visualizza i dati di un determinato articolo del negozio, in particolare il titolo e l’immagine ad esso associato. Forse dovremmo scrivere un test per controllarli in modo specifico? Per esempio:
test("renders correctly", () => {
  const wrapper = shallowMount(Item, createConfig());
  // Wrong
 expect(wrapper.find("h2").text()).toBe(item.title);
}
Questo è un altro test non necessario in quanto sta solo testando la capacità di Vue di acquisire dati da Vuex e di interpolarli nel modello. La libreria Vue ha già dei test per questo meccanismo, quindi dovremmo fidarci del suo funzionamento senza ulteriori test.
TEST
3: rendering corretto
Ragioniamo per assurdo. Cosa succede se qualcuno rinomina accidentalmente il
titolo e poi dimentica di aggiornare l’interpolazione? Dovremmo testare anche
questo?
Si certo, ma se proviamo ogni aspetto del modello che stiamo creando, dove sono
i nostri limiti di testing?
Il modo migliore per testare il markup è usare un test snapshot per controllare
l’output del rendering complessivo. I test snapshot salvano il markup del
componente Vue e lo confrontano con quello nuovo generato ogni volta che viene
eseguito un test. Se qualcosa cambia lo sviluppatore viene avvisato e può
decidere se la modifica è stata intenzionale o accidentale. Questo coprirà non
solo l’interpolazione del titolo, ma anche l’immagine, il testo del pulsante,
eventuali classi e altro ancora.
test("renders correctly", () => {
  const wrapper = shallowMount(Item, createConfig());
  expect(wrapper).toMatchSnapshot();
});
Per
finire, ecco alcuni esempi di altre parti che non è necessario testare:
• Se la proprietà src è associata all’elemento img,
• Se i dati aggiunti all’archivio Vuex sono gli stessi che sono
interpolati,
• Se la proprietà calcolata ritorna l’oggetto giusto,
• Se il router push reindirizza alla pagina corretta.
Considerazioni finali
I tre test relativamente semplici che abbiamo appena fatto sono sufficienti per questo semplice componente. Una buona mentalità da avere quando si fa il testing dei componenti è quella di considerare un test non necessario fino a prova contraria. Ecco le principali domande che vi dovreste porre quando vi approciate al testing:
• Fa parte della logica del componente?
• Questo test verifica direttamente input e output del componente?
• Sto testando il mio codice o il codice di terze parti?
Ricordiamoci che i test sono una parte fondamentale di qualsiasi applicazione seria e in fase di produzione. All’inizio quando la vision non è chiara, lo Unit Test potrebbe rallentare lo sviluppo, ma una volta stabiliti gli utenti e i test necessari (e non ridondanti), questi sono assolutamente necessari per assicurarci che il codice di base sia mantenibile e scalabile nel tempo.
Inoltre i test sono molto utili durante lo sviluppo, sia per aiutare lo sviluppatore a pensare come progettare in maniera adeguata un componente, sia per fare il refactoring di un componente esistente, e spesso vengono eseguiti ogni volta che qualcosa viene modificato.
Buon testing a tutti!!
FONTE: https://medium.com/js-dojo/knowing-what-to-test-vue-component-unit-testing-f19b5880906a
CONCORRENZA E BLOCCO JPA: LA GUIDA COMPLETA PER SCEGLIERE LA GIUSTA STRATEGIA
Immaginate di avere un sistema distribuito ed utilizzato da molti utenti che contemporaneamente cercano di modificare la stessa entità. Come si garantisce all’utente che l’integrità dei dati sottostanti al sistema stesso sia preservata anche quando si accede simultaneamente?
La risposta è semplice: Java Persistance API.
Java Persistance API è una specifica Java per l’accesso, la persistenza e la gestione dei dati tra oggetti (JAVA) e Database relazionali come MySQL, PostgreSQL, SQL server e Oracle.
Generalmente i provider di persistenza offrono una strategia di blocco (“locking” in inglese) per gestire la concorrenza. Esistono principalmente due tipi di blocco: quello pessimistico e quello ottimistico.
Prima di addentrarci in questo ambito, cerchiamo di fare chiarezza su cosa sono le transazioni ACID e quanto sono importanti per i database moderni.
ACID che significa Atomico, Coerente, Isolato e Durevole, assicura che una transazione del database sia completata in modo tempestivo. Una transazione all’interno di un database può essere suddivisa in più componenti: i database compatibili con ACID, ossia quelli relazionali, assicurano che una transazione sia mantenuta ed eseguita solo quando tutti i componenti della transazione stessa hanno esito positivo. Se uno qualsiasi dei componenti fallisce, la transazione verrà ripristinata e non verrà apportata alcuna modifica.
In caso di più transazioni, dobbiamo definire una strategia di blocco per assicurarci che l’integrità dei dati sottostanti sia preservata.
Andiamo più nel dettaglio e cerchiamo di capire come i due tipi di blocco funzionano nello specifico.
BLOCCO OTTIMISTICO
La specifica JPA fornisce l’annotazione javax.persistance per contrassegnare una proprietà con l’attributo @Version di una entità. Questa proprietà può essere un campo numerico (int, long, short) o java.sql.timestamp. Può esistere solo una proprietà con annotazione @Version per entità e l’attributo deve trovarsi nella tabella principale per un’entità mappata su più tabelle.
@Entity
public class User{

@Id
@Column (name = "ID", nullable = false)
@GeneratedValue (strategy = GenerationType.AUTO)
private long id;

@Version
private long version;

@OneToMany(mappedBy = "user", cascade = CascadeType.ALL)
private List<Order> orders = new ArrayList<>();

}
Qui, ogni transazione che legge i dati contiene il valore della proprietà @Version e prima di modificare i dati sottostanti, si verifica il valore.
Se nel frattempo il valore è cambiato, verrà lanciata una eccezione chiamata OptimisticLockException e verrà eseguito il rollback (ossia si ricopiano indietro i dati copiati in precedenza) della transazione. In caso contrario la transazione esegue il commit dell’aggiornamento e aumenta il valore della @Version.
MODALITA’ DI BLOCCO OTTIMISTICHE
JPA fornisce due modalità di blocco ottimistico: OPTIMISTIC e OPTIMISTIC_FORCE_INCREMENT.
• OPTIMISTIC ottiene il blocco in lettura per le entità con proprietà @Version.
• OPTIMISTIC_FORCE_INCREMENT invece, ottiene sempre il blocco di lettura per le entità con la proprietà @Version e incrementa quel valore.
BLOCCO PESSISTICO
In caso di blocco pessimistico, JPA crea una transazione che ottiene un blocco sui dati fino al completamento della transazione. Ciò quindi impedisce ad altre transazioni di apportare aggiornamenti all’entità fino al rilascio del blocco. Il blocco pessimistico è molto utile quando i dati sono frequentemente accessibili e modificabili da più transazioni.
Bisogna tenere presente che l’utilizzo del blocco pessimistico comporta una riduzione notevole delle prestazioni dell’applicazione se le entità non sono suscettibili a frequenti modifiche.
MODALITA’ DI BLOCCO PESSIMISTICO
JPA con questo tipo di blocco offre tre modalità: PESSIMISTIC_READ, PESSIMISTIC_FORCE_INCREMENT e PESSIMISTIC_WRITE.
• PESSIMISTIC_READ ottiene un blocco di lettura a lungo termine sui dati per impedire che questi vengano aggiornati o eliminati: le altre transazioni possono leggere i dati durante il blocco, ma non sono in grado di aggiornarli o eliminarli.
•PESSIMISTIC_FORCE_INCREMENT ottiene sempre un blocco di lettura a lungo termine sui dati per impedire modifiche, ma inoltre aumenta la proprietà della @Version.
• PESSIMISTIC_WRITE invece, ottiene un blocco di lettura a lungo termine sui dati per impedire sempre l’eliminazione o l’aggiornamento, ma anche la lettura dall’esterno.
Se non è possibile avere un blocco pessimistico, si ottiene un rollback della transazione e verrà generata una PessimisticLockException. Tuttavia, se il blocco fallisce e non risulta un rollback della transazione, verrà generata una LockTimeOutException.
CONCLUSIONI
A seconda delle esigenze della vostra applicazione, scegliete bene la giusta strategia di blocco e applicare la strategia solo se necessario. L’approccio ottimistico migliora le prestazione ma al contempo diminuisce la sicurezza, quello pessimistico migliora notevolmente la sicurezza ma le prestazioni diminuiscono di conseguenza. A seconda dell’ambito è giusto adottare un approccio piuttosto che un altro. A voi la scelta!
Inizia a usare TensorFlow.js — Senza lasciare questo articolo

Uno dei più grandi ostacoli per i principianti che stanno facendo esperienza con l'intelligenza artificiale e il machine learning può essere il setup.
Non mentiamo, ci capita ancora di sprecare un sacco di giorni cercando di far cooperare Python, TensorFlow e la GPU. Questo ci fa mettere in discussione le nostre capacità di ingegnere del software? Sì, eccome.
Ora però stiamo divagando.
Dunque,
cos’è TensorFlow.js e come ci può aiutare? Dalla pagina ufficiale, TensorFlow.js è: “Una libreria JavaScript per la
formazione e la distribuzione di modelli ML nel
browser e su Node.js.”
Cosa
significa per noi? Possiamo provarlo direttamente da questo articolo!
La Demo
In questa demo utilizziamo un modello di deep learning chiamato “MobileNet”. MobileNet è un tipo di Rete Neurale Convoluzionale, un modello di architettura utile per la classificazione delle immagini.

Nota: Per saperne di più su ciò che vede realmente l'intelligenza artificiale, da’ un’occhiata a questo articolo.
Il codice
Utilizzare
TensorFlow.js per classificare un'immagine con MobileNet è facile quanto 3
linee di codice:
mobilenet.load()

  .then(model => model.classify(myImage))

  .then(predictions => // Use predictions)
Riflessioni finali
Al
momento della stesura di questo post TensorFlow offre 5 modelli ufficiali, tutti
altrettanto facili da utilizzare:
- mobilenet: Classifica immagini con etichette dal database ImageNet.
- posenet: Rilevamento posa in tempo reale.
- coco-ssd: Rilevamento dell'oggetto basato sul rilevamento oggetti API TensorFlow.
- speech-commands: Classifica frammenti audio da 1 secondo dal dataset comandi vocali.
- knn-classifier: Crea un classificatore personalizzato dei K vicini più prossimi. Può essere usato per trasferire l'apprendimento.
Tuttavia, se nessuno di questi modelli
è sufficiente, è anche possibile creare/formare il proprio modello, ma questo è
un altro articolo.
Per divertimento, vi sfidiamo a guardare la documentazione di PoseNet e cercare di eguagliare i risultati della foto di copertina.
Fonte: https://medium.com/hackernoon/start-using-tensorflow-js-without-leaving-this-article-fb683ac509ed